La replica su larga scala di Mindspark in India (NBER, settembre 2025) trova +0,22σ in matematica e +0,20σ in hindi dopo 18 mesi, ma nessun effetto sugli esami scolastici. In Kenya EIDU registra 0,534 SD sui bambini del pre-primario, in Ghana un chatbot su WhatsApp 0,36 d in 11 scuole. Tre numeri che non si sommano, e due dei tre sistemi non sono nemmeno “tutor AI”.
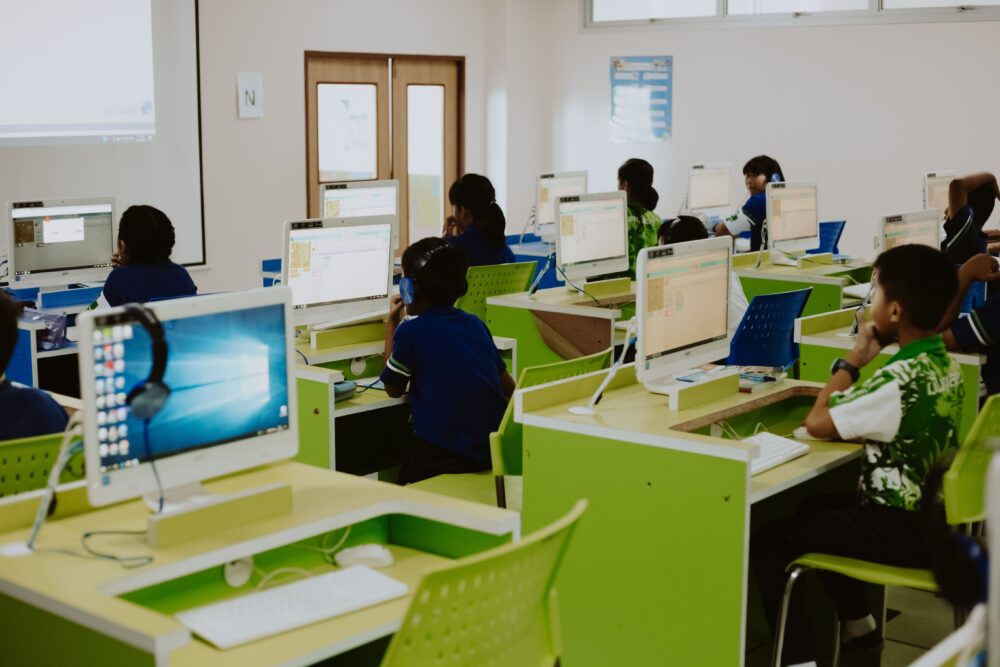
In 40 scuole Adarsh di quattro distretti del Rajasthan, per diciotto mesi, una parte dell’ora di matematica è stata sostituita da un computer. Non un’ora intera: circa un quarto del tempo di lezione alla primaria, fra il 40 e il 50 per cento alla secondaria di primo grado. Altre 40 scuole hanno continuato come prima. Alla fine, i ricercatori hanno somministrato i loro test a circa 6.500 studenti e hanno trovato un guadagno di 0,22 deviazioni standard in matematica e 0,20 in hindi. Poi hanno guardato gli esami scolastici — quelli che finiscono sulla pagella, quelli che contano per le famiglie — e non hanno trovato nessun effetto. Le stime puntuali erano addirittura negative.
Il sistema in questione si chiama Mindspark, è sviluppato dall’indiana Educational Initiatives, ed è un software adattivo: un motore che, a partire dalle risposte date dallo studente, stima il suo livello effettivo e gli serve l’esercizio successivo tarato su quel livello, non sul programma della classe. È apprendimento automatico applicato a un dominio molto ristretto — diagnosi del livello e selezione del contenuto — e non ha niente a che vedere con i modelli linguistici generativi di cui si parla oggi quando si dice “tutor personale”. Questa distinzione, che sembra pedante, è il centro di tutta la faccenda.
Tre studi che vengono citati insieme e non parlano della stessa cosa
Quando il settore edtech vuole dimostrare che “funziona”, cita tipicamente un terzetto: l’India di Mindspark, il Kenya di EIDU, il Ghana di Rori. Sono effettivamente tre esperimenti randomizzati seri, e sono effettivamente tutti positivi. Il problema è che vengono impilati come se misurassero la stessa grandezza con la stessa tecnologia.
Non è così. Vale la pena mettere i tre casi uno accanto all’altro proprio per vedere quanto poco si assomiglino:
- India, Mindspark. Replica su scala dello studio pilota di Delhi (Muralidharan, Singh, Ganimian, American Economic Review 2019, che su centri doposcuola urbani aveva trovato +0,37σ in matematica). La nuova valutazione è di Muralidharan e Singh, NBER Working Paper 34205, settembre 2025, campione oltre venti volte più grande dell’originale. Software adattivo, dentro l’orario scolastico, test indipendenti, 18 mesi.
- Kenya, EIDU. RCT da ottobre 2022 a ottobre 2023 nella contea di Murang’a, 291 scuole, bambini fra i 4 e i 6 anni del pre-primario. Misurazione con IDELA, lo strumento di Save the Children, su tre rilevazioni. Effetto complessivo 0,534 SD (p<0,001), con numeracy e literacy entrambe intorno a 0,45. Pubblicato su Research Papers in Education. Anche qui: software adattivo su dispositivo, non un modello generativo.
- Ghana, Rori. Questo sì è un chatbot — un tutor di matematica che vive dentro WhatsApp, sviluppato da Rising Academies. Preprint su arXiv del 2024 (Henkel e colleghi), 11 scuole della rete Rising, uso durante lo study hall, effetto d = 0,36.
Età diverse (4-6 anni contro studenti di terza e oltre), strumenti diversi (IDELA contro test costruiti dai ricercatori contro valutazione interna), durate diverse (otto mesi contro un anno contro diciotto). Mettere 0,534, 0,36 e 0,22 nella stessa slide e concludere che il più grande è il migliore è un errore di misura, non una sintesi.
Il risultato scomodo non è il nullo: è la divergenza
La tentazione, leggendo il dato indiano, è di titolare che il software non funziona. Sarebbe falso. Gli effetti sull’apprendimento misurato dai ricercatori sono positivi e statisticamente solidi, e gli autori li traducono in un aumento della produttività del tempo scolastico fra il 50 e il 66 per cento: lo stesso minuto d’aula rende di più. I guadagni risultano proporzionali al tempo effettivamente passato sulla piattaforma, il che è esattamente il comportamento che ci si aspetta da un intervento che fa qualcosa di reale e non da un artefatto.
La cosa interessante è l’altra. Gli stessi bambini, sugli esami della scuola, non vanno meglio. Gli autori propongono una spiegazione: il software punta al livello effettivo dello studente, e in India la distanza fra il livello effettivo e il programma della classe è enorme. Un ragazzo di terza media che il motore adattivo riporta correttamente agli automatismi di quarta elementare impara qualcosa di importante — e però quel qualcosa non è ciò su cui verrà interrogato a fine anno. È un’ipotesi degli autori, non un fatto dimostrato. Ma se è giusta, dice una cosa che nessuna brochure commerciale dirà mai: la personalizzazione, per funzionare, deve smettere di inseguire il curriculum, e una scuola è un’istituzione costruita interamente attorno al curriculum.
Un sistema che insegna a ciascuno quello che gli serve, in un’istituzione che valuta tutti su quello che serve alla classe, produrrà sempre due numeri che non coincidono. La domanda non è quale sia vero: lo sono entrambi.
Chi misura, e con quale distanza
C’è poi una questione che va dichiarata invece di essere lasciata nelle note a piè di pagina. Nessuno di questi studi è un’accusa di malafede, ma le distanze fra valutatore e valutato non sono tutte uguali.
Lo studio indiano è registrato come trial (AEARCTR-0002546), finanziato nell’ambito del programma RISE, e gli autori segnalano che Educational Initiatives aveva ricevuto fondi dal Global Innovation Fund per sviluppare proprio il modello poi valutato. Il paper su Rori è firmato anche da personale di Rising Academies, cioè del fornitore, ed è un preprint di cui non risulta una pubblicazione peer-reviewed. EdTech Hub, che ha condotto la valutazione keniota, è anche partner operativo di EIDU. Sono informazioni che un lettore ha diritto di avere prima di leggere l’effect size, non dopo.
Aggiungiamoci che le fonti non concordano nemmeno sui numeri di base: la scheda di EdTech Hub parla di 1.995 bambini valutati, l’abstract della rivista di 1.955; per il Ghana il preprint e le sintesi indipendenti parlano di circa 500 studenti, la pagina di Rising Academies di circa mille, stesse undici scuole, stesso 0,36. Discrepanze piccole, che però dicono qualcosa sullo stato della letteratura: è giovane, è parzialmente auto-riportata, e viene citata con una sicurezza che non si è ancora guadagnata.
Cosa è successo davvero alla promessa del tutor per ciascuno
La promessa commerciale — un precettore personale, instancabile, per ogni bambino del pianeta — è un’affermazione sui modelli generativi. Le prove sperimentali più robuste che abbiamo, invece, riguardano software adattivi di generazione precedente, che fanno una cosa sola e la fanno bene: capire a che punto è davvero lo studente e dargli l’esercizio giusto. Il solo dei tre sistemi che somiglia a un tutor conversazionale, Rori, è anche quello con la base probatoria più sottile: undici scuole, un preprint, e un trial più ampio su cinque distretti che è tuttora in corso e di cui non esistono risultati.
Nel frattempo la diffusione corre comunque. Mindspark, nel 2024-25, risulta presente in oltre 2.200 scuole pubbliche indiane, più di 266.000 studenti, tredici stati. EIDU ha firmato nel 2022 accordi con 46 delle 47 contee keniote per un rollout progressivo. Le decisioni di politica scolastica, in altre parole, vengono prese su una base di evidenza che è solida ma strettissima — e che riguarda una tecnologia diversa da quella che i ministeri credono di stare comprando.
Un ultimo dettaglio, dal Rajasthan, che vale più di molti dibattiti sull’AI generativa: il modello in orario scolastico è risultato circa due volte più costo-efficace di quello pomeridiano. Non per qualcosa che riguarda il software. Perché nel doposcuola i bambini ci vanno quando possono, e dentro l’orario ci sono già.